翻译 | 信号检测论的贝叶斯估计 (一)
原标题:Bayesian Estimation of Signal Detection Models, Part 1
原文地址:https://vuorre.netlify.app/post/2017/10/09/bayesian-estimation-of-signal-detection-theory-models-part-1/
原作者:Matti. Vuorre
译者:王倩 王齐飞 张译文
校对:胡传鹏 金海洋 姚佳宇
引言
假如我们在进行一项再认实验,这个实验向被试呈现了一组图片,这些图片中有些是新的(被试之前没有见过的),而有些是旧的(被试之前已看过的)。被试需要对呈现的每一张图片进行反应:“新(未见过)”或者“旧(见过)”。SDT通过分别测量被试的敏感性以及判断标准(一种对反应偏向(response bias)测量)来建立每个被试再认过程的模型。SDT模型的基本理念是:在每个试次中,当刺激呈现时,被试心里会产生一种“熟悉”(或者记忆强度)的信号。随后被试会依据这些信号,判断当前的刺激是“新”或“旧”。Macmillan 和 Creelman(2005)一书中对SDT有更加详细的介绍。
信号检测理论
假如我们在进行一项再认实验,这个实验向被试呈现了一组图片,这些图片中有些是新的(被试之前没有见过的),而有些是旧的(被试之前已看过的)。被试需要对呈现的每一张图片进行反应:“新(未见过)”或者“旧(见过)”。SDT通过分别测量被试的敏感性以及判断标准(一种对反应偏向(response bias)测量)来建立每个被试再认过程的模型。SDT模型的基本理念是:在每个试次中,当刺激呈现时,被试心里会产生一种“熟悉”(或者记忆强度)的信号。随后被试会依据这些信号,判断当前的刺激是“新”或“旧”。Macmillan 和 Creelman(2005)一书中对SDT有更加详细的介绍。
案例数据
接下来我们将用R统计编程语言来探究一个实例,首先我们需要加载tidyverse工具包(Wickham,2016)
library(tidyverse)
devtools::install_github("cran/sdtalt")
# install.packages("sdtalt")
library(sdtalt)
data(confcontr)
## # A tibble: 3,100 x 3
##    subno sayold isold
##   <dbl> <dbl> <dbl>
##  1    53      1     0
##  2    53      1     1
##  3    53      1     1
##  4    53      1     1
##  5    53      1     0
##  6    53      1     1
##  7    53      1     0
##  8    53      0     0
##  9    53      0     1
## 10    53      0     1
## # ... with 3,090 more rows
在这篇文章中,我们将利用这些数据来估算该数据包中的某个被试在等方差SDT模型下的参数d’ (辨别力指标/感觉敏感性指标)和 c(报告标准)。
等方差高斯SDT模型
首先我们讨论最常见的SDT模型,即假定被试对两种信号的熟悉程度的分布属于高斯分布(即正态分布),且这两个分布的方差是齐性的,但均值可能不同(例如,对旧刺激的熟悉程度更高)。该模型就称为EVSDT (Equal Variance Gaussian SDT Model) 模型。我们用三种方法来估算单个被试的模型:
1. 依据计算公式,使用R进行“手动”点估计运算;2. 使用贝叶斯广义线性模型(GLM;Generalized linear models)来进行估算;
3. 使用贝叶斯非线性模型来进行估算。
EVSDT参数的点估计
首先,我们分别对数据包中每一位被试的EVSDT参数进行最大似然估计。在此之前,我注意到只有在手动点估计运算时才需要进行这种数据处理,因此接下来所介绍的建模方法,都将采用原始数据,以略去繁琐的步骤。首先,我们将计算被试每个试次的反应(击中(hit)、虚报(false alarm)、正确拒斥(correct rejection)、漏报(miss))并将其放到新变量type中:
sdt <- confcontr %>%
    mutate(type = "hit",
           type = ifelse(isold==1 & sayold==0, "miss", type),
           type = ifelse(isold==0 & sayold==0, "cr", type),  # Correct rejection
           type = ifelse(isold==0 & sayold==1, "fa", type))  # False alarm
sdt <- sdt %>%
    group_by(subno, type) %>%
    summarise(count = n()) %>%
    spread(type, count)  # Format data to one row per person
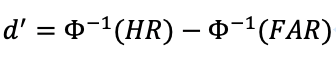
Φ 是累积正态密度函数(cumulative normal density function),可将z分数转换为概率,其反函数Φ^(-1) 将概率(例如击中率或虚报率)转换为z分数。标准化后的击中率和虚报率分别表示为 zHR 和zFAR。反应标准c则由-zFAR(负虚报率的标准分数)表示(DeCarlo,1998)。
我们可以用qnorm()进行z分数转化(即Φ^(-1))。接下来,根据每个被试反应类型(击中,虚报,漏报,正确拒斥)的数量计算出d’ 和c :
sdt <- sdt %>%
    mutate(zhr = qnorm(hit / (hit+miss)),
           zfa = qnorm(fa / (fa+cr)),
           dprime = zhr-zfa,
           crit = -zfa)
round(sdt, 2)
## # A tibble: 31 x 9
## # Groups:   subno [31]
##    subno    cr    fa   hit  miss   zhr    zfa dprime  crit
##    <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
##  1    53    33    20    25    22  0.08 -0.31    0.39 0.31
##  2    54    39    14    28    19  0.24 -0.63    0.87 0.63
##  3    55    36    17    31    16  0.41 -0.47    0.88 0.47
##  4    56    43    10    38     9  0.87 -0.88    1.76 0.88
##  5    57    35    18    29    18  0.3  -0.41    0.71 0.41
##  6    58    41    12    30    17  0.35 -0.75    1.1  0.75
##  7    59    46     7    21    26 -0.13 -1.12    0.98 1.12
##  8    60    38    15    33    14  0.53 -0.570   1.1  0.570
##  9    61    42    11    25    22  0.08 -0.81    0.9  0.81
## 10    62    45     8    22    25 -0.08 -1.03    0.95 1.03
## # ... with 21 more rows
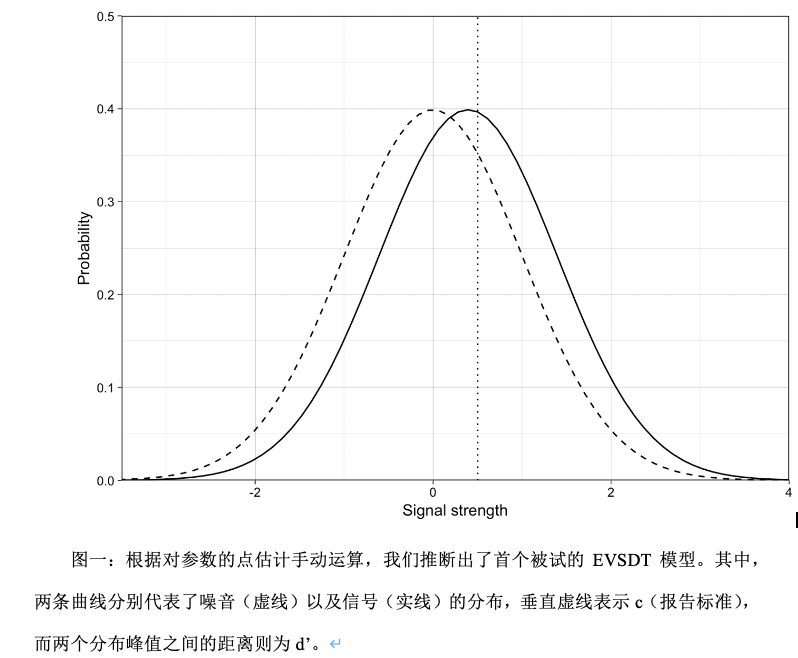
现在,我们根据这些数据就得到了每个被试d’ 和c的点估计, 53号被试的潜在EVSDT模型如图一所示:
使用GLM估算EVSDT模型
广义线性模型是一类功能强大的回归模型,可以对二项反应进行建模,例如前文所提到的对“新”或“旧”的反应。在confcontr中,每个试次都有一种回答,“旧”(sayold = 1) 或者 “新” (sayold = 0);我们用GLM对刺激类型的反应进行回归:需要判断的刺激(图片)可能是新的(isold = 0)也可能是旧的(isold = 1)。在二项反应的GLM中,我们假定反应属于贝努里(Bernoulli)分布(即只有一个试次的二项分布),且其概率$p_i$为$y_i=1$
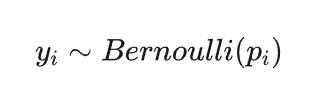
由于我们希望使用线性模型(广义线性模型)对概率p进行估计,但概率p本身有上限和下限(分别为1和0),因此,我们不用线性模型直接对p进行建模。相反,我们用一个连结函数将p转化为‘线性预测值’ η,并用线性回归模型对 η建模。如果该连结函数是一个概率(probit),那我们就得到了一个‘probit GLM’。
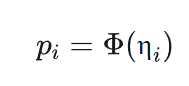
如前所述,Φ是一个累积正态密度函数并能将z 值转化为概率,那我们可以用一个截距和斜率来表示η。
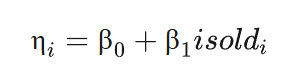
在这一参数化过程中,模型的截距是标准化的虚报率(当η为0时报告1的概率),我们将其作为标准,用c表示。模型的斜率是由z分数所表示的击中率(当η为1时报告1)相对于截距(即标准化的虚报率)的提升,这是d’的另一种表达形式。因此,
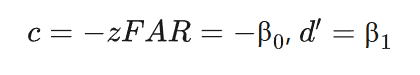
DeCarlo (1998)已详细地探讨了SDT模型与GLM的关系。从GLM框架来考虑SDT模型的两个直接好处是,可以容易得到c和d'两个预测值以及可用层级模型来估计包含各种相关系数的SDT模型(DeCarlo,2010; Rouder & Lu, 2005)。第二点意味着多个被试(和项目)可同时用该模型进行拟合。我们将在第二部分中讨论这一点。
因为我们把SDT写成了一个GLM模型,我们有多种多样的软件可以对这个模型进行估计。这里我们使用贝叶斯回归模型R语言工具包brms (Bürkner 2017; Stan Development Team 2016),因为其模型公式的语法可以很好地用于我们之后要探讨的更复杂的模型。
通过输入一个在brms语法下的模型公式,一个用连结函数处理过的反应分布以及一个数据框架(data frame)作为参数(arguments),我们就可以用brms的brm()函数来估计GLM。brms的模型语法用了数据中的变量名。我们用公式sayold ~ isold来回归二元预测值isold 的二项反应sayold。
接下来需要输入参数,即反应分布,用参数family表示,我们用 family = bernoulli(link="probit")这一语法来表示有概率连结函数的贝努里分布。这里我们只需要第一个被试的数据(subno 53),因此,用data = filter(confcontr, subno==53)来表示该数据。 brm()函数也允许设定参数的先验分布,但这个模型中我们略去对先验的讨论。最后,我们将参数cores设置为4以运行多个马氏链(chains;这能使模型估计得更快)。根据以上的设置,我们可以把SDT作为一个probit GLM进行估计。估计confcontr数据中53号被试SDT模型的具体函数如下:
library(brms)
glmfit <- brm(sayold ~ isold,
              family = bernoulli(link="probit"),
              data = filter(confcontr, subno==53),
              cores = 4,
              file = here::here("static/data/sdtmodel1-1"))
summary(glmfit)
##  Family: bernoulli
##   Links: mu = probit
## Formula: sayold ~ isold
##    Data: filter(confcontr, subno == 53) (Number of observations: 100)
## Samples: 4 chains, each with iter = 2000; warmup = 1000; thin = 1;
##          total post-warmup samples = 4000
##
## Population-Level Effects:
##           Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
## Intercept    -0.32      0.18    -0.67     0.03       3340 1.00
## isold         0.40      0.26    -0.11     0.90       3207 1.00
##
## Samples were drawn using sampling(NUTS). For each parameter, Eff.Sample
## is a crude measure of effective sample size, and Rhat is the potential
## scale reduction factor on split chains (at convergence, Rhat = 1).
round(sdt[1,], 2)
## # A tibble: 1 x 9
## # Groups:   subno [1]
##   subno    cr    fa   hit  miss   zhr   zfa dprime  crit
##
## 1    53    33    20    25    22  0.08 -0.31   0.39  0.31
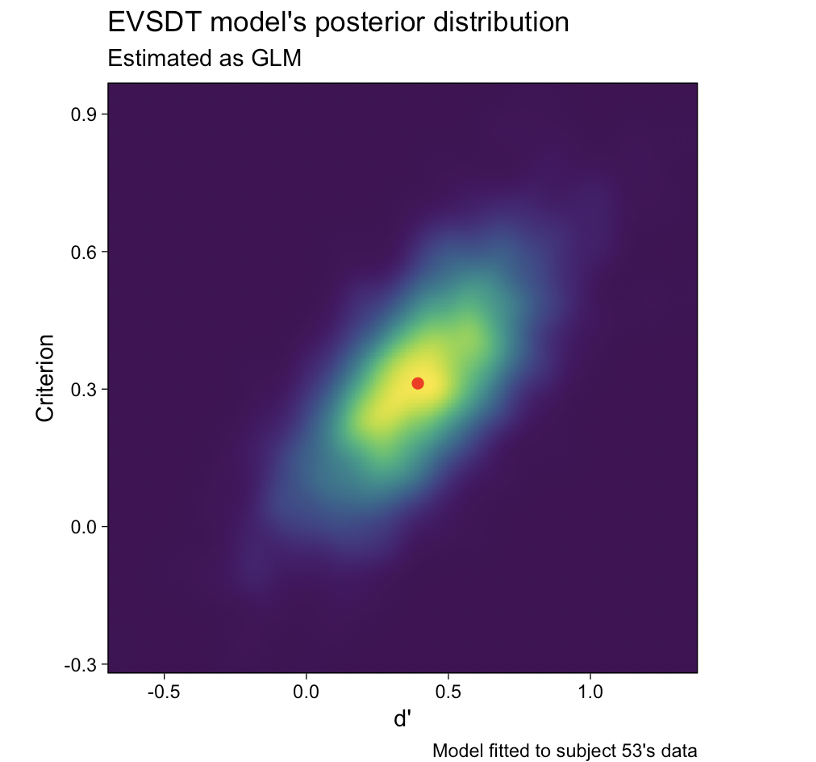
图2可以引发一些有趣的思考:如果我们忽略参数估计的不确定性(峰值附近色团的可信度降低)会怎么样?答案是,如果实验设计在被试间是平衡的,忽略特定被试间的个体差异对推断平均数基本不会有影响。那如果我们将点估计值作为一些回归的预测值,而忽略其不确定性呢?使用极不确定的估计值会有什么影响?我们还应该相信那些众数吗?无论怎么样,我都希望以上这些已经说明了等方差高斯SDT的参数很容易在GLM框架下获得。接下来,我将介绍如何使用brms的非线性模型语法来估计SDT模型。
使用非线性模型估计等方差高斯信号检测论(UVSDT)
等方差高斯信号检测论(EVSDT)模型一种常见泛化是允许信号与噪声分布的方差不同。该模型被称为不等方差高斯信号检测论模型(UVSDT:unequal variance Gaussian SDT model)。UVSDT模型是非线性的,因此需要不同的估计方法。brms语法中可以建立非线性模型。有关UVSDT模型的讨论会放到之后系列的第3部分。这里我们将使用brms的非线性建模语法对GLM模型进行拟合,作为接下来对UVSDT拟合的先导知识。在这里,我们用与GLM类似的方式编写EVSDT模型,只是简单地了翻转c和d'。我们将直接给出参数c,不需要再翻转估计的参数值。在第3部分中,我们将此模型泛化为不等方差模型,从而获得一个非线性模型。因此,拟合上述GLM的变式是很有用的,它能帮助我们熟悉brms的非线性建模语法。对此,我们编写模型如下(DeCarlo 1998):
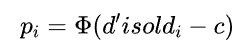
该模型可以直接估算c和d'。与拟合GLM相比,编写和估计非线性模型要复杂得多。因此,下面的代码会有点复杂。但重要的是,我们可以使用brms来估计非线性模型,且使用方式也不会过度偏离基本的公式语法。
首先,我们将使用bf()函数指定模型,如下所示: 回归参数【Intercept (c=−β0)和 isold (d′=β1)】显示在以上代码结果中 “Population-Level Effects”部分。Estimate是后验均值,相当于最大似然估计,Est.Error 是后验标准差,相当于标准误。其后的两列是参数95%的可信区间(credible intervals; CIs)。估计参数的均值与手动计算的点估计值相符。
m2 <- bf(sayold ~ Phi(dprime*isold - c),
         dprime ~ 1, c ~ 1,
         nl = TRUE)
Priors <- c(prior(normal(.5, 1.5), nlpar = "dprime"),
          prior(normal(0, 1.5), nlpar = "c"))
fit2 <- brm(m2,
            family = bernoulli(link="identity"),
            data = filter(confcontr, subno==53),
            prior = Priors,
            control = list(adapt_delta = .99),
            cores = 4,
            file = here::here("static/data/sdtmodel1-2"))
summary(glmfit)
##  Family: bernoulli
##   Links: mu = probit
## Formula: sayold ~ isold
##    Data: filter(confcontr, subno == 53) (Number of observations: 100)
## Samples: 4 chains, each with iter = 2000; warmup = 1000; thin = 1;
##          total post-warmup samples = 4000
##
## Population-Level Effects:
##           Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
## Intercept    -0.32      0.18    -0.67     0.03       3340 1.00
## isold         0.40      0.26    -0.11     0.90       3207 1.00
##
## Samples were drawn using sampling(NUTS). For each parameter, Eff.Sample
## is a crude measure of effective sample size, and Rhat is the potential
## scale reduction factor on split chains (at convergence, Rhat = 1).
summary(fit2)
##  Family: bernoulli
##   Links: mu = identity
## Formula: sayold ~ Phi(dprime * isold - c)
##          dprime ~ 1
##          c ~ 1
##    Data: filter(confcontr, subno == 53) (Number of observations: 100)
## Samples: 4 chains, each with iter = 2000; warmup = 1000; thin = 1;
##          total post-warmup samples = 4000
##
## Population-Level Effects:
##                  Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
## dprime_Intercept     0.39      0.25    -0.12     0.87       1266 1.00
## c_Intercept          0.31      0.17    -0.03     0.66       1267 1.00
##
## Samples were drawn using sampling(NUTS). For each parameter, Eff.Sample
## is a crude measure of effective sample size, and Rhat is the potential
## scale reduction factor on split chains (at convergence, Rhat = 1).
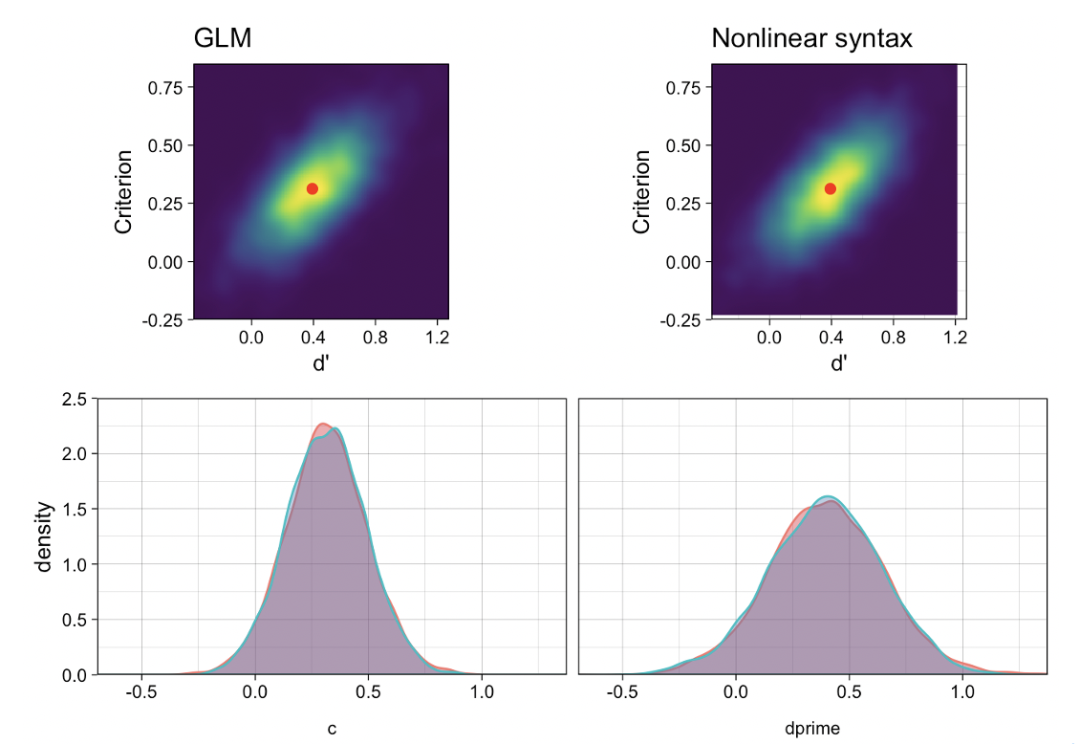
两个模型的结果非常相似,但需要注意的是:先验仅包含在非线性语法模型中。唯一的不同点是,MCMC算法探索fit2后验的效率较低,正如两个参数的Eff.Sample 较小所反映的。这意味着对于fit2,从后验分布中随机样本拥有更大的自相关,因此我们应该抽取更多样本以进行更准确的推断。用这两种方法获得的后验分布如图3所示。
讨论
用不同的方法拟合单个被试的EVSDT模型
本篇博客中,我们使用了三种方法来估计单个被试数据的等方差高斯SDT模型的参数:手动计算点估计值,使用probit GLM,和使用Brms的非线性建模语法的Probit模型。目前为止,这些方法之间的主要区别在于建模方法可以提供参数估计的不确定性,而手动计算则不能。这个原因直接引领我们更偏向层级模型(Rouder and Lu 2005; Rouder et al. 2007),我们将在第2部分中对其进行讨论。但是,使用回归模型框架估算SDT模型还有其他好处。例如,通过“手动”计算可能会涉及到一些运算错误,这可能比直接使用原始数据的方法更容易出错。如果使用建模方法的话,贝叶斯建模方法易于应用并为广大读者所使用 (Bü rkner 2017)。建模能够通过交叉的“随机”效应(Rouder et al. 2007)以及可能影响SDT参数的协变量来包含多种变异源,比如跨项目和被试之间的异质性(Rouder等,2007)。通过更改连接函数,我们还可以使用其他分布(例如逻辑回归分布;logistic)来表示信号和噪声的分布(DeCarlo 1998,2010)。
先验分布
刚开始接触贝叶斯建模方法的新手可能会反对使用先验分布,并认为他们过分地影响了结果。但是适度提供信息的先验对推理的影响并没有想象中那么大。上述我们指定的GLM模型并没有使用任何先验信息。另外,使用非线性建模功能会使情况变得更加复杂:在这种情况下,先验主要用来帮助从合理的参数值中提取后验样本。此外,先验在估计SDT模型方面非常有用:如果参与者的命中率或误报率是0或1(一种相当普遍的情况),原则上可以使用适度的先验(mild prior information can be used in a principled manner to release the estimated quantities from hostile captivity of the boundary values)。Stanislaw 和 Todorov在文献中讨论了对0和1比率的各种校正(Stanislaw and Todorov 1999)。但是,贝叶斯先验可以更有原则性地处理这些极端情况。在下一篇文章中,我们将重点介绍层级SDT模型,贝叶斯的优点将变得尤为突出。
参考文献
[1] Bürkner, Paul-Christian. 2017. “Brms: An R Package for Bayesian Multilevel Models Using Stan.” Journal of Statistical Software 80 (1): 1–28. https://doi.org/10.18637/jss.v080.i01.
[2] DeCarlo, Lawrence T. 1998. “Signal Detection Theory and Generalized Linear Models.” Psychological Methods 3 (2): 186–205. https://doi.org/10.1037/1082-989X.3.2.186.
[3] DeCarlo. Lawrence T. 2010. “On the Statistical and Theoretical Basis of Signal Detection Theory and Extensions: Unequal Variance, Random Coefficient, and Mixture Models.” Journal of Mathematical Psychology 54 (3): 304–13. https://doi.org/10.1016/j.jmp.2010.01.001.
[4] Kruschke, John K. 2014. Doing Bayesian Data Analysis: A Tutorial Introduction with R. 2nd Edition. Burlington, MA: Academic Press.
[5] Macmillan, Neil A., and C. Douglas Creelman. 2005. Detection Theory: A User’s Guide. 2nd ed. Mahwah, N.J: Lawrence Erlbaum Associates.
[6] R Core Team. 2017. R: A Language and Environment for Statistical Computing. Vienna, Austria: R Foundation for Statistical Computing. https://www.R-project.org/.
[7] Rouder, Jeffrey N., and Jun Lu. 2005. “An Introduction to Bayesian Hierarchical Models with an Application in the Theory of Signal Detection.” Psychonomic Bulletin & Review 12 (4): 573–604. https://doi.org/10.3758/BF03196750.
[8] Rouder, Jeffrey N., Jun Lu, Dongchu Sun, Paul Speckman, Richard D. Morey, and Moshe Naveh-Benjamin. 2007. “Signal Detection Models with Random Participant and Item Effects.” Psychometrika 72 (4): 621–42. https://doi.org/10.1007/s11336-005-1350-6.
[9] Skagerberg, Elin M., and Daniel B. Wright. 2008. “Manipulating Power Can Affect Memory Conformity.” Applied Cognitive Psychology 22 (2): 207–16. https://doi.org/10.1002/acp.1353.
[10] Stan Development Team. 2016. RStan: The R Interface to Stan. http://mc-stan.org/.
[11] Stanislaw, Harold, and Natasha Todorov. 1999. “Calculation of Signal Detection Theory Measures.” Behavior Research Methods, Instruments, & Computers 31 (1): 137–49. http://link.springer.com/article/10.3758/BF03207704.
[12] van Ravenzwaaij, Don, Pete Cassey, and Scott D. Brown. 2016. “A Simple Introduction to Markov Chain Monte–Carlo Sampling.” Psychonomic Bulletin & Review, March, 1–12. https://doi.org/10.3758/s13423-016-1015-8.
[13] Wickham, Hadley. 2016. Tidyverse: Easily Install and Load ’Tidyverse’ Packages. https://CRAN.R-project.org/package=tidyverse.
[14] Wright, Daniel B. 2011. Sdtalt: Signal Detection Theory and Alternatives. https://CRAN.R-project.org/package=sdtalt.