翻译 | 信号检测论的贝叶斯估计 (二)
原标题:Bayesian Estimation of Signal Detection Models, Part 2
原文地址:https://vuorre.netlify.app/post/2017/10/12/bayesian-estimation-of-signal-detection-theory-models-part-2/
原作者:Matti. Vuorre
译者:高昊 田宇浩
校对:胡传鹏 金海洋 于玮烨
引言
本篇博文承接第一部分。在第一部分中我们使用以下三种方法对一个被试的EVSDT模型的参数进行估计:
- 手动计算点估计(Stanislaw and Todorov,1999)- 使用广义线性模型(GLM)来估计(DeCarlo,1998)
- 使用brm非线性模型语法进行估计(Burkner,2017)
但是,与参加实验的某些特定被试相比,研究者通常会对他们所代表的总体更感兴趣。因此,我们不会满足于那些恰巧参加了我们研究的被试的参数估计结果。最终统计模型的参数应该能描述研究者所感兴趣的总体的特征。
一般来说,有两种方法可以得到总体水平的参数。目前而言,最流行的方法是对每个被试进行点估计,即手动计算d’和c的均值和标准差。基于该方式,我们可以计算标准误,t值,置信区间等。另外一种我想推广的方法是建立一个更广的,可以同时估计被试水平和总体水平参数的模型。我们称后面这种方法为“层级”(Hierarchical)或“多水平”(Multilevel)模型(Gelman and Hill,2007; Rouder and Lu,2005) 。
在本篇博客中,我会使用R语言和brms 包来展示如何使用上述两种方法估计EVSDT模型中总体水平的参数(R Core Team 2017; Bürkner 2017)。
示例数据
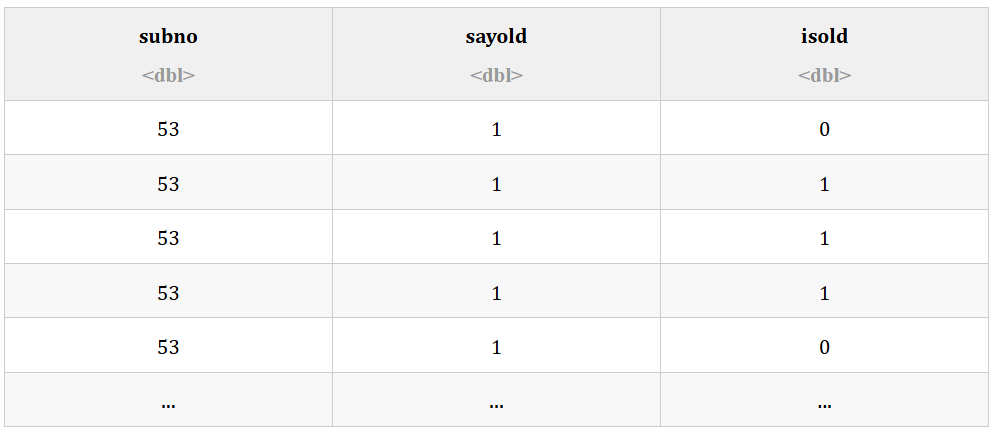
我们在本篇博客中将继续使用第一部分中使用的数据集。示例数据叫做confcontr,是以dataframe的格式存储的:“ 这些数据来自于Skagerberg和Wright关于记忆一致性研究的对照组。它使用的基本可以算是最简单的新旧再认记忆的实验设计”(Skagerberg and Wright 2008)。
为了完整,我们重复呈现第一部分的一些代码,如下所示
library(tidyverse)
library(sdtalt)
data(confcontr)
# We prefer working with "tibbles" over "data.frame"s
confcontr <- as_tibble(confcontr)
confcontr
# Create a variable in data indicating if trial was hit/miss/etc.
sdt <- confcontr %>%
    mutate(type = "hit",
           type = ifelse(isold==1 & sayold==0, "miss", type),
           type = ifelse(isold==0 & sayold==0, "cr", type),  # Correct rejection
           type = ifelse(isold==0 & sayold==1, "fa", type))  # False alarm
# Count hits/misses/etc. and format data to one row per person
sdt <- sdt %>%
    group_by(subno, type) %>%
    summarise(count = n()) %>%
    spread(type, count)  # Format data to one row per person
# Calculate point estimates of EVSDT parameters
sdt <- sdt %>%
    mutate(zhr = qnorm(hit / (hit+miss)),
           zfa = qnorm(fa / (fa+cr)),
           dprime = zhr-zfa,
           crit = -zfa)
总体水平EVSDT模型
我们现在通过手动计算和层级模型两种方法来估计这些数据总体水平的EVSDT模型的参数。对于多水平的模型,我提供了R和brms代码来估计广义线性混合模型(GLMM, Generalized Linear Mixed Model)的参数。我也会介绍如何用brm非线性语法来估计GLMM模型的参数,以此来帮助我们理解第三部分中所使用的不等方差模型。
总基于整合被试点估计的参数估计体水平EVSDT模型
之前,我们计算了样本集合中每一个被试的d'和c| subno | cr | fa | hit | miss | zhr | zfa | dprime | crit |
|---|---|---|---|---|---|---|---|---|
| 53 | 33 | 20 | 25 | 22 | 0.0801 | -0.312 | 0.393 | 0.312 |
| 54 | 39 | 14 | 28 | 19 | 0.2423 | -0.631 | 0.873 | 0.631 |
| 55 | 36 | 17 | 31 | 16 | 0.4113 | -0.466 | 0.877 | 0.466 |
| 56 | 43 | 10 | 38 | 9 | 0.8724 | -0.883 | 1.755 | 0.883 |
| 57 | 35 | 18 | 29 | 18 | 0.2977 | -0.413 | 0.711 | 0.413 |
sdt_sum <- select(sdt, subno, dprime, crit) %>%  # Select these variables only
    gather(parameter, value, -subno) %>%  # Convert data to long format
    group_by(parameter) %>%  # Prepare to summarise on these grouping variables
    # Calculate summary statistics for grouping variables
    summarise(n=n(), mu=mean(value), sd=sd(value), se=sd/sqrt(n))
sdt_sum
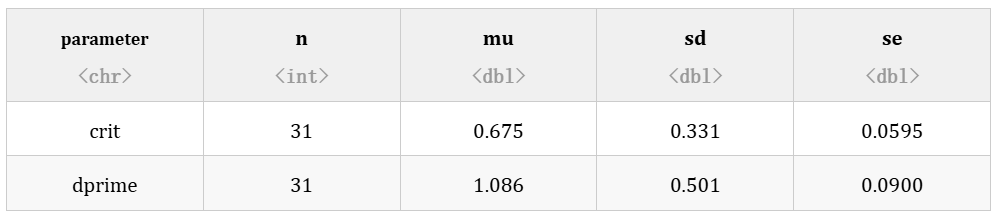
样本均值(mu)是对群体均值的估计,样本标准差(sd)除以是对样本分布标准差的估计,也就是标准误差(se)。由于抽样分布的标准差是未知的,而且只能通过数据进行估计,因此,研究者几乎总是用t分布来代替高斯分布来获得p值和置信区间(也就是说,我们进行t检验,而不是z检验)。
在这里需要注意的是该方法涉及到对未知参数的点估计(被试水平(subject-specific)的参数),接着用额外的模型来整合这些参数。换而言之,我们首先拟合包含了P个参数的N个模型(这里N=被试数量,P=2个参数),紧接着再用P个模型来总结被试水平的参数。这包含了相当多的模型!
下一步,我们将会使用层级回归方法一步获得被试水平和总体水平的参数。
基于层级模型的参数估计(GLMM)
我们可以使用EVSDT模型来估计每一位被试的参数,随后用广义线性混合模型(GLMM)进一步估计总体的均值。Gelman, Hill(2007)和McELreath(2016)对层级模型有很好且全面的介绍。Rouder和 Lu(2005) 和 Rouder等人(2007)在信号检测理论的框架下讨论了层级模型。
该模型与第一部分讨论的GLM十分相似,但是现在被试特有的d’和c是来自同一个多元正态分布。该模型中的“超参数(hyperparameter)”描述了总体水平的参数。我们用下标j描述被试j的参数,下标i描述数据的第 i 行,因此模型可以写成,
$$ y_{ij} \sim \text{Bernoulli}(p_{ij})$$ $$ Phi(p_{ij}) = \beta_{0j} + \beta_{1j} \text{isold}_{ij}$$当被试 j 在第 i 次试验(trial)上的反应是新的(“new!”),那么结果$y_{ij} = 0$;当被试j在第 i 次试验上的反应是旧的(“old!”),那么结果$y_{ij} = 1$. 第 j 个被试在第i次试验上的反应为旧的的概率记作$p_{ij}$。然后,我们针对$p_{ij}$概率(z分数;Φ,“Phi”)编写线性模型。
被试水平的截距(回忆上一部分,$β_0 = -z\text{FAR}$)和斜率($β_1 = d'$)是由一个具有均值和协方差矩阵的多元正态分布来描述的。
$$ \begin{bmatrix} \beta_{0j} \\ \beta_{1j} \end{bmatrix} \sim N \left( \begin{bmatrix} \mu_0 \\ \mu_1 \end{bmatrix}, \Sigma \right) $$平均值$μ_0$和$μ_1$是总体水平的参数,可以解释为所有人的平均参数(Bolger and laurenceau 2013).协方差矩阵Σ包含了被试水平参数的(协)方差。但是我发现讨论标准差(我称之为τ)和相关会更加简单。标准差描述了总体中个体之间的异质性。相关描述了d’和c的协方差,即有更高d’的样本是否有更大可能性有更高的c?
与运行多个独立的GLM相比,这个模型包含了更多的信息,因为它可以对协方差进行建模,并且有效回答了有关异质性(heterogeneity)的重要问题。
这个模型的brms语法与单个被试的模型很像。我们需要估计5个总体水平的参数。截距和斜率描述的是均值:在R和brms模型语法中,截距恒等为1(可以省略,因为它是自动包含的,为清楚起见,这里将其包含在内),一个变量的斜率通过包含数据中的那个变量名称来表示。为了包含这两个回归系数,我们记为sayold ~ 1 + isold.
但是,我们还需要估计三个(协)方差参数。为了包含被试水平的参数(回顾,在数据d中,被试被标记为subno)和(协)方差参数,我们可以扩展上述公式,表示为sayold ~ 1 + isold + (1 + isold | subno). 括号中的部分描述了被试subno指定的截距为1,斜率为isold。brm()调用的其他部分与第一部分相同。
fitglmm <- brm(sayold ~ 1 + isold + (1 + isold | subno),
               family = bernoulli(link="probit"),
               data = confcontr,
               cores = 4,
               file = here::here("static/data/sdtmodel2-1"))
接下来我们看一下GLMM估计的参数。首先,我们聚焦输出结果中的“总体水平效应(Population-Level Effects)”。这两个参数分别是平均判断标准c(截距Intercept,$μ_0$)和d'(斜率isold,$μ_1$)。我们正在查看的是参数后验分布(中随机抽取的样本)的数值综合情况: Estimate是后验平均值。
summary(fitglmm)
##  Family: bernoulli
##   Links: mu = probit
## Formula: sayold ~ 1 + isold + (1 + isold | subno)
##    Data: confcontr (Number of observations: 3100)
## Samples: 4 chains, each with iter = 2000; warmup = 1000; thin = 1;
##          total post-warmup samples = 4000
##
## Group-Level Effects:
## ~subno (Number of levels: 31)
##                      Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
## sd(Intercept)            0.26      0.06     0.16     0.39       1616 1.00
## sd(isold)                0.39      0.08     0.25     0.56       1168 1.00
## cor(Intercept,isold)    -0.57      0.19    -0.85    -0.12       1196 1.00
##
## Population-Level Effects:
##           Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
## Intercept    -0.66      0.06    -0.79    -0.55       1756 1.00
## isold         1.06      0.09     0.88     1.23       1784 1.00
##
## Samples were drawn using sampling(NUTS). For each parameter, Eff.Sample
## is a crude measure of effective sample size, and Rhat is the potential
## scale reduction factor on split chains (at convergence, Rhat = 1).
这些均值可以通过颜色密度图展示出来(如图1左侧的图)。但是,GLMM也提供了对总体水平参数(协)方差的估计。注意,我们也计算了提供这些信息的样本标准差,但我们没有对这些点估计的不确定性进行估计。另一方面,GLMM提供了这些参数的后验分布。
异质性的参数呈现在"群组水平效应" (Group-Level Effects)表格中。我们发现报告标准的标准差(c)与d'是正相关的。这两个标准差的可视化如图1右侧所示。
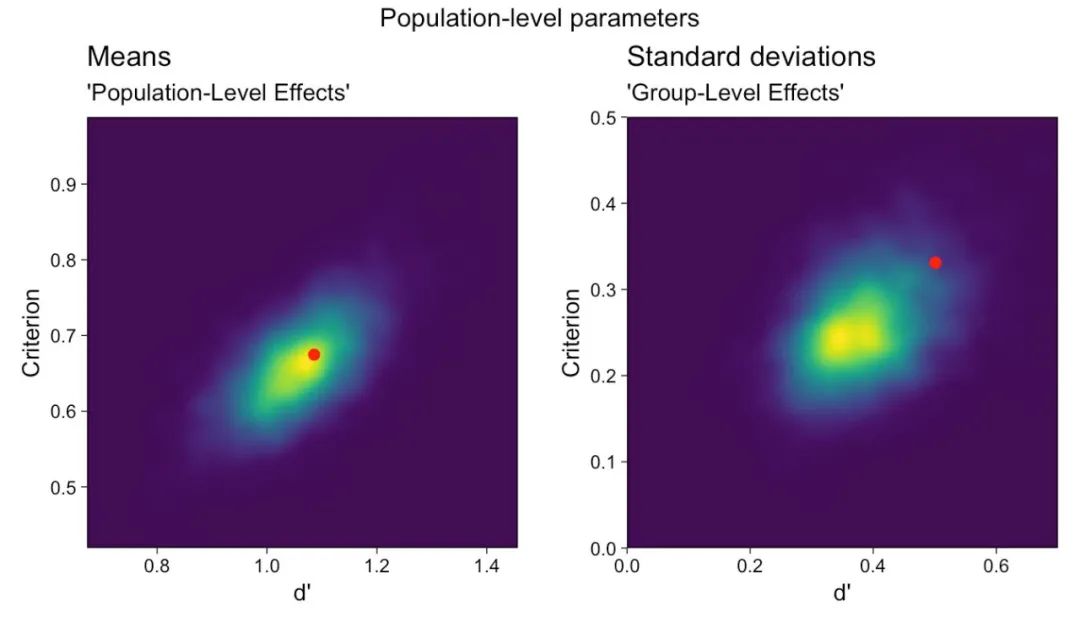
很明显在图1中,样本的均值与后验众数近似,但样本的标准差远离标准差后验分布的峰值点。与考虑了被试水平参数不确定性的GLMM模型相比,手动计算的方法忽略被试特有参数的不确定性,进而高估了总体的d'和c的异质性。
对两种方法估计被试水平参数的探索还有更深层次的含义。回想一下,手动计算方法涉及到对每一个样本参数(点)估计一个独立的模型。层级模型会同时考虑所有被试的数据,并且通过共享先验分布允许估计之间相互借鉴 (公式的右侧重复上述的公式)。
$$ \begin{bmatrix} \beta_{0j} \\ \beta_{1j} \end{bmatrix} \sim N \left( \begin{bmatrix} \mu_0 \\ \mu_1 \end{bmatrix}, \Sigma \right) $$ 信息的“部分汇集(partial pooling)”(Gelman and Hill,2007)是很明显的,当我们在相同的散点图中画出N个GLMM被试特有参数(对每个被试分别进行点估计):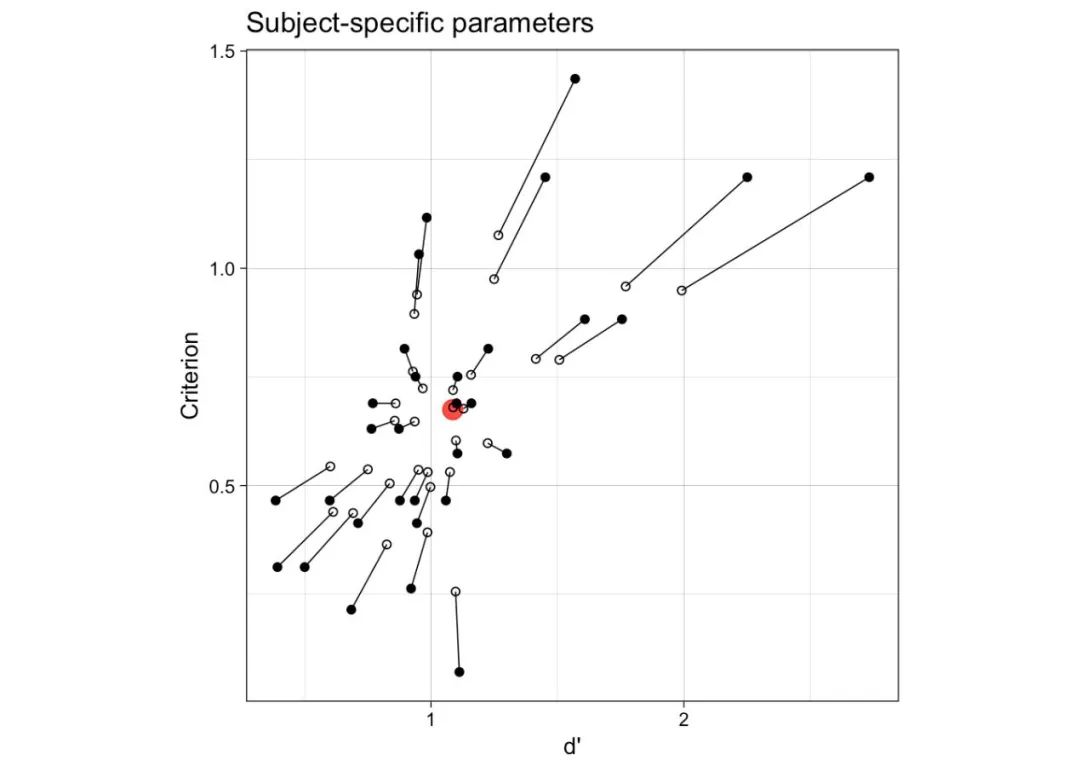
我们可以看到,用一个层级模型同时对多个被试估计EVSDT模型既简单又有用。特别是,现在可以很容易地在参数中包含预测变量,并回答有关d '和c可能受到的影响的问题。
包含预测因子
EVSDT参数在组别之间是否有不同?在不同条件是否有不同?为了回答这些问题,我们会尽可能的重复手动计算的这些参数,紧接着用一个ANOVA模型来分析所有被试特有的参数进而做出推断。GLMM方法提供了纳入预测变量的更直接的解决方案:我们只需在回归模型中添加参数。
例如,假设有两个组别的样本,即数据中变量group,我们可以扩展brms GLMM语法(“...”表示上面使用的其他参数的占位符,我也删除了“1”,因为它们是默认包含的):
brm(sayold ~ isold*group + (isold | subno), ...)
brm(sayold ~ isold*condition + (isold*condition | subno), ...)
基于GLMM(非线性语法)的参数估计
这里我简单的介绍用brms非线性语法拟合上述GLMM,进而引出在第三部分不等方差SDT模型。基础模型是直接对第一部分单个样本的模型进行改写,描述如下
$$ p_{ij} = Φ\left(d_j'\text{isold}_{ij}-c_j\right) $$与GLMM一样,变化的d’和标准c被建模为一个多元正态分布。事实证明,这个相当复杂的模型可以很容易地用brms来拟合。这个公式与第一部分单个被试模型很相似,但我们使用bf()来设置d’,标准c和他们相应的被试水平的参数,以及总体水平的参数。
在上面GLMM中,被试水平的效应是通过(1 + isold | subno)进行设定的。借助非线性模型语法,我们使用 |s|而不是 |来设定多参数间变化的效应,告诉brms这些参数应该在同一个协方差矩阵中。这个语法让我们得到Rouder et. al(2007)所讨论的“相关随机效应信号检测模型”。除了这个语法,这个模型与上述的GLMM模型一样,但是截距的符号相反
Priors <- c(prior(normal(0, 3), nlpar = "dprime", lb = 0),
            prior(normal(0, 3), nlpar = "c"),
            prior(student_t(10, 0, 1), class = "sd", nlpar = "dprime"),
            prior(student_t(10, 0, 1), class = "sd", nlpar = "c"),
            prior(lkj(4), class = "cor"))
我们像之前一样拟合这个模型,但是调整control的参数,设置inits为0来提高采样效率(感谢Tom Wallis 给的建议):
fitglmm2 <- brm(glmm2,
                family = bernoulli(link="identity"),
                data = confcontr,
                prior = Priors,
                control = list(adapt_delta = .99),
                cores = 4, inits = 0,
                file = here::here("static/data/sdtmodel2-2"))
summary(fitglmm)
##  Family: bernoulli
##   Links: mu = probit
## Formula: sayold ~ 1 + isold + (1 + isold | subno)
##    Data: confcontr (Number of observations: 3100)
## Samples: 4 chains, each with iter = 2000; warmup = 1000; thin = 1;
##          total post-warmup samples = 4000
##
## Group-Level Effects:
## ~subno (Number of levels: 31)
##                      Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
## sd(Intercept)            0.26      0.06     0.16     0.39       1616 1.00
## sd(isold)                0.39      0.08     0.25     0.56       1168 1.00
## cor(Intercept,isold)    -0.57      0.19    -0.85    -0.12       1196 1.00
##
## Population-Level Effects:
##           Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
## Intercept    -0.66      0.06    -0.79    -0.55       1756 1.00
## isold         1.06      0.09     0.88     1.23       1784 1.00
##
## Samples were drawn using sampling(NUTS). For each parameter, Eff.Sample
## is a crude measure of effective sample size, and Rhat is the potential
## scale reduction factor on split chains (at convergence, Rhat = 1).
summary(fitglmm2)
##  Family: bernoulli
##   Links: mu = identity
## Formula: sayold ~ Phi(dprime * isold - c)
##          dprime ~ 1 + (1 | s | subno)
##          c ~ 1 + (1 | s | subno)
##    Data: confcontr (Number of observations: 3100)
## Samples: 4 chains, each with iter = 2000; warmup = 1000; thin = 1;
##          total post-warmup samples = 4000
##
## Group-Level Effects:
## ~subno (Number of levels: 31)
##                                   Estimate Est.Error l-95% CI u-95% CI
## sd(dprime_Intercept)                  0.36      0.07     0.22     0.51
## sd(c_Intercept)                       0.24      0.05     0.15     0.35
## cor(dprime_Intercept,c_Intercept)     0.42      0.20    -0.05     0.73
##                                   Eff.Sample Rhat
## sd(dprime_Intercept)                    1558 1.00
## sd(c_Intercept)                         1071 1.00
## cor(dprime_Intercept,c_Intercept)       1403 1.00
##
## Population-Level Effects:
##                  Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
## dprime_Intercept     1.06      0.08     0.90     1.23       2025 1.00
## c_Intercept          0.66      0.06     0.55     0.77       2294 1.00
##
## Samples were drawn using sampling(NUTS). For each parameter, Eff.Sample
## is a crude measure of effective sample size, and Rhat is the potential
## scale reduction factor on split chains (at convergence, Rhat = 1).
因为技术的原因,每一个参数在fitglmm2有一个_Intercept后缀,但是这个结果是一样的。在下一篇博客,我们进一步使用这种语法来估计不等方差高斯SDT模型。
讨论
对被试内设计和重复测量数据进行建模时,与传统方法如(多元)方差分析(ANOVA)相比,层级模型技术有几个优势。例如,以前需要使用被试特有模型的参数作为输入的许多模型现在可以在单个模型中建模。层级模型自动地考虑到了不平衡数据,并允许包含连续预测变量和离散的因变量。在SDT的特定背景下,我们注意到,层级模型还估计了一些重要参数。这些参数描述了总体中可能存在的人际之间的差异性。
我们注意到,层级模型的流行趋势似乎正在加速。许多实证论文现在使用多水平模型来分析数据,而不是使用重复测量方差分析(repeated measures-ANOVA),这表明在应用研究背景下存在对这些模型的需求。那么将更复杂的,可能是非线性的模型概念化为层级模型值得拥有一个统一的数据分析框架。此外,通过包含人与人之间差异的参数,这些模型允许研究人员量化他们感兴趣效应的变化程度,以及有可能的话,这些效应是不是存在于人群中的每个人身上。
参考文献
[1] Bolger, Niall, and Jean-Philippe Laurenceau. 2013. Intensive Longitudinal Methods: An Introduction to Diary and Experience Sampling Research. Guilford Press. http://www.intensivelongitudinal.com/.
[2] Bürkner, Paul-Christian. 2017. “Brms: An R Package for Bayesian Multilevel Models Using Stan.” Journal of Statistical Software 80 (1): 1–28. https://doi.org/10.18637/jss.v080.i01.
[3] DeCarlo, Lawrence T. 1998. “Signal Detection Theory and Generalized Linear Models.” Psychological Methods 3 (2): 186–205. https://doi.org/10.1037/1082-989X.3.2.186.
[4] Gelman, Andrew, and Jennifer Hill. 2007. Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press.
[5] McElreath, Richard. 2016. Statistical Rethinking: A Bayesian Course with Examples in R and Stan. CRC Press.
[6] R Core Team. 2017. R: A Language and Environment for Statistical Computing. Vienna, Austria: R Foundation for Statistical Computing. https://www.R-project.org/.
[7] Rouder, Jeffrey N., and Jun Lu. 2005. “An Introduction to Bayesian Hierarchical Models with an Application in the Theory of Signal Detection.” Psychonomic Bulletin & Review 12 (4): 573–604. https://doi.org/10.3758/BF03196750.
[8] Rouder, Jeffrey N., Jun Lu, Dongchu Sun, Paul Speckman, Richard D. Morey, and Moshe Naveh-Benjamin. 2007. “Signal Detection Models with Random Participant and Item Effects.” Psychometrika 72 (4): 621–42. https://doi.org/10.1007/s11336-005-1350-6.
[9] Skagerberg, Elin M., and Daniel B. Wright. 2008. “Manipulating Power Can Affect Memory Conformity.” Applied Cognitive Psychology 22 (2): 207–16. https://doi.org/10.1002/acp.1353.
[10] Stan Development Team. 2016. Stan: A C++ Library for Probability and Sampling, Version 2.15.0. http://mc-stan.org/.
[11] Stanislaw, Harold, and Natasha Todorov. 1999. “Calculation of Signal Detection Theory Measures.” Behavior Research Methods, Instruments, & Computers 31 (1): 137–49. http://link.springer.com/article/10.3758/BF03207704.