翻译 | 信号检测论的贝叶斯估计 (三)
原标题:Bayesian Estimation of Signal Detection Models, Part 3
原文地址:https://vuorre.netlify.app/post/2017/10/12/bayesian-estimation-of-signal-detection-theory-models-part-3/
原作者:Matti. Vuorre
译者:刘帅呈 高昊
校对:胡传鹏 金海洋 于玮烨
引言
案例数据:评级任务
我们首先使用来自Decarlo(2003)的示例数据,简单地讨论一下评级任务。在之前的文章中,我们讨论了信号检测实验。这个实验中的实验材料要么是旧的,要么是新的,被试对实验材料进行 “旧”或“新”的二项的反应。在这里,我们将对实验任务进行简单的修改,被试将表达他们的(不)确定性:即在每个试次(trial)中呈现的实验材料依旧是旧的或者新的,但是被试需要对他们关于刺激材料的判断做出确信度评级。例如,在下面的数据中,参与者可以用数字来回答,表示他们认为这个项目是旧的确信度:1 =肯定是新的,…,6 =肯定是旧的。
对于结果数据的一个解释是,被试为确信度评级设置了许多标准,例如:反应为6比反应为4需要更多的证据。也就是说,在回答“肯定是新的”、“可能是新的”等问题时,会有不同的标准。然而,被试的辨别力应该不受影响。
下面的案例数据以一种汇总的形式呈现(整理了新或者旧(isold=1)两种试次类型中每个确信度的反应数量(Decarlo,2003)):
library(tidyverse)
dsum <- tibble(
      isold = c(0,0,0,0,0,0,1,1,1,1,1,1),
      y =c(1:6, 1:6),
      count = c(174, 172, 104, 92, 41, 8, 46, 57, 66, 101, 154, 173)
      )
dsum
  ## # A tibble: 12 x 3
  ##   isold     y count
  ##   <dbl> <int> <dbl>
  ## 1   0   1  174
  ## 2   0   2  172
  ## 3   0   3  104
  ## 4   0   4  92
  ## 5   0   5   41
  ## 6   0   6   8
  ## 7   1   1   46
  ## 8   1   2   57
  ## 9   1   3   66
  ## 10   1   4   101
  ## 11   1   5   154
  ## 12   1   6   173
然而,这几篇博客文章的一个主题是:我们不需要将数据汇总为计数数据(或单元(cell)数据,或类似的),而是尽可能的直接使用实验提供的原始数据。我认为,特别是当我们想包含协变量时,使用这种试次水平的数据在计算和概念上都更容易。以下是原始试次水平格式的数据:
d <- tibble(
      isold = c(rep(0, 174), rep(0, 172), rep(0, 104), rep(0, 92), rep(0, 41), rep(0, 8),
      rep(1, 46), rep(1, 57), rep(1, 66), rep(1, 101), rep(1, 154), rep(1, 173)),
      y = c(rep(1, 174), rep(2, 172), rep(3, 104), rep(4, 92), rep(5, 41), rep(6, 8),
      rep(1, 46), rep(2, 57), rep(3, 66), rep(4, 101), rep(5, 154), rep(6, 173))
  )
  d
  ## # A tibble: 1,188 x 2
  ##    isold     y
  ##    <dbl> <dbl>
  ##  1     0     1
  ##  2     0     1
  ##  3     0    1
  ##  4     0     1
  ##  5     0     1
  ##  6     0     1
  ##  7     0     1
  ##  8     0     1
  ##  9     0     1
  ## 10     0     1
  ## # ... with 1,178 more rows
(上面的代码不够整洁,如果有人知道可以把汇总数据整理为整洁的试次水平数据的其他方法,请告诉我。)如果你想在自己的电脑上面尝试,可以在R语言上执行上述代码。我们现在可以从EVSDT模型开始,让信号检测论模型拟合这个被试的数据。
EVSDT:一个被试的评级反应
回忆一下,二项反应的EVSDT模型中,我们对概率P(在试次i中是旧的反应)进行了建模:
$$ p_i = Φ(d'\text{isold}_i - C) $$该模型呈现了对新的实验材料反应为旧(c=zFAR)的概率(z分数),以及对旧的实验材料反应依然为旧(d')的增量(z分数)。对于评级数据,模型是相似的,只是现在包含了多个c。这表示对不同确信度评级反应的不同标准。这些标准被认为是有顺序的——当试次中的信号(记忆强度)较弱时,与报告“确定为旧”相比,人们应该更容易报告“不确定为旧”。
评级反应的EVSDT模型对反应确信度评级为k或更低(信心评级)的累计概率进行建模:
$$ p(y_i \ ≤ k_i) = Φ(d'\text{isold}_i - C_{ki}) $$该模型也被称为序数概率Φ模型(Ordinal Probit Model),它可以通过很多回归模型软件进行拟合。Decarl(2003)展示了在SPSS中如何使用PLUM程序拟合单个被试的模型。然而,我们可以通过在R语言中brms工具包(Bürkner,2017; Stan Development Team,2016)估计这个模型并得到该模型的贝叶斯推论。使用该模型(暂时不考虑先验分布)对上述数据进行估计的brms语法如下:
fit1 <- brm(y ~ isold,
            family = cumulative(link="probit"),
            data = d,
            cores = 4,
          file = here::here("static/data/sdtmodel3-1"))
该模型估计了每个反应类别的截距(反应标准)和isold的效应,即d'。模型的后验分布总结如下:
summary(fit1)
  ##  Family: cumulative
  ##   Links: mu = probit; disc = identity
  ## Formula: y ~ isold
  ##    Data: d (Number of observations: 1188)
  ## Samples: 4 chains, each with iter = 2000; warmup = 1000; thin = 1;
  ##          total post-warmup samples = 4000
  ##
  ## Population-Level Effects:
  ##              Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
  ## Intercept[1]    -0.44      0.05    -0.54    -0.35       4256 1.00
  ## Intercept[2]     0.23      0.05     0.14     0.33       5885 1.00
  ## Intercept[3]     0.67      0.05     0.57     0.77       4736 1.00
  ## Intercept[4]     1.20      0.06     1.09     1.31       4620 1.00
  ## Intercept[5]     1.88      0.07     1.75     2.01       4436 1.00
  ## isold            1.26      0.07     1.13     1.39       4157 1.00
  ##
  ## Samples were drawn using sampling(NUTS). For each parameter, Eff.Sample
  ## is a crude measure of effective sample size, and Rhat is the potential
  ## scale reduction factor on split chains (at convergence, Rhat = 1).
5个截距是模型中的5个标准,isold为d'。我也用SPSS对这个模型进行了估计,比较这两种方法的结果可能会有帮助:
PLUM y WITH x
  /CRITERIA=CIN(95) DELTA(0) LCONVERGE(0) MXITER(100) MXSTEP(5) PCONVERGE(1.0E-6) SINGULAR(1.0E-8)
  /LINK=PROBIT
  /PRINT=FIT KERNEL PARAMETER SUMMARY.
Parameter Estimates
|-----------------|--------|----------|-----------------------------------|
|                 |Estimate|Std. Error|95% Confidence Interval            |
|                 |        |          |-----------------------|-----------|
|                 |        |          |Lower Bound            |Upper Bound|
|---------|-------|--------|----------|-----------------------|-----------|
|Threshold|[y = 1]|-.442   |.051      |-.541                  |-.343      |
|         |-------|--------|----------|-----------------------|-----------|
|         |[y = 2]|.230    |.049      |.134                   |.326       |
|         |-------|--------|----------|-----------------------|-----------|
|         |[y = 3]|.669    |.051      |.569                   |.769       |
|         |-------|--------|----------|-----------------------|-----------|
|         |[y = 4]|1.198   |.056      |1.088                  |1.308      |
|         |-------|--------|----------|-----------------------|-----------|
|         |[y = 5]|1.876   |.066      |1.747                  |2.005      |
|---------|-------|--------|----------|-----------------------|-----------|
|Location |x      |1.253   |.065      |1.125                  |1.381      |
|-------------------------------------------------------------------------|
Link function: Probit.
不出所料,从brms得到的数值结果(后验均值和标准差,可信区间)与从SPSS中得到的频率论结果相匹配。
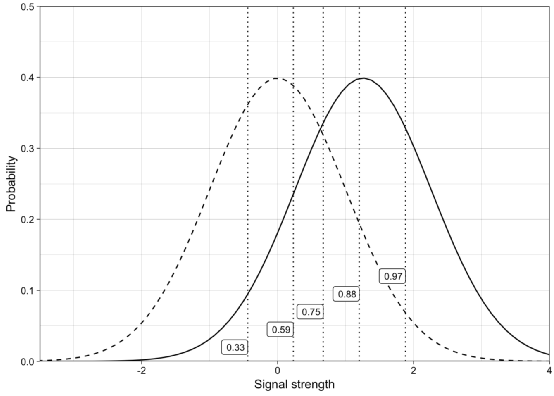
现在我们可以用图形来说明估计的参数如何映射到信号检测论模型。d'是信号和噪音分布峰值之间的距离:表示被试分辨信号和噪音的能力。这5个截距是指对不同确信度评级的标准(z分数)。如果把z分数换算成比例(例如使用R语言中的pnorm()函数),他们测量的是在噪音分布下z分数左边的累积面积(模型图见图1)。
UVSDT:一个被试的评级反应
值得注意的是,上面的模型假设信号和噪音分布的方差相等。不等方差SDT模型(UVSDT)允许信号分布和噪音分布有不同的方差(噪音的标准差还是固定为1),并且当允许信号分布的标准差变化时,它始终大于1。
UVSDT模型增加了一个参数(Decarlo,2003)来描述信号分布的标准差。我们可以把它作为一个比例参数包含在上面的公式中。但是因为标准差的参数一定大于零,为方便起见,可以使用$\text{log}(σ_\text{old}) = a$:
$$ p(y_i \le k_i) = \Phi\left(\frac{d' \cdot \text{isold}_i - c_k}{\exp(a \cdot \text{isold}_i)}\right) $$这种非线性模型,也被称为不等误差概率模型(a probit model with heteroscedastic error, 例如:DeCarlo (2010)),可以使用brms工具包进行估计。最初,我认为我们可以写出非线性brms公式来描述序数概率模型,但是brms不支持非线性累积序数模型。然后,我开始修改原始的Stan代码去估算该模型,尽管这样做可行,但对于开展实证研究却不太实用,因为并不是每个人都想编写Stan代码。
在与brms的创建者Paul Bürkner进行多次交流之后(Paul Bürkner在免费和开源软件上做了很多努力,应该为他颁发金牌),我发现,在默认情况下brms在序数回归模型中包含类似的参数。如果您向上滚动并查看fit1的总结,你可以在最上面看到该模型的公式为:
Formula: y ~ isold
         disc = 1
换句话说,有一个“discrimination”参数disc,默认情况下设置为1。这里是brms如何参数化序数概率模型的:
$$ p(y_i \le k_i) = \Phi\left(disc * \left( c_{ki} - d' \text{isold}_i\right)\right) $$重要的是,我们还可以在disc上包含预测变量。在这种情况下,当isold为1时,我们想对disc进行估计。因此,新实验材料的disc为1,但是旧实验材料的disc需要从实验数据中估计得来。默认情况下,该参数是通过对数链接函数(a log linkfunction)进行建模,因此包含一个0/1预测因子(isold)就应该可以正常工作:
$$ p(y_i \le k_i) = \Phi\left(\exp(disc\text{isold}_i) * \left( c_{ki} - d' \text{isold}_i\right)\right) $$因此,我们只需对EVSDT模型的代码进行一些细微调整即可估算该模型:
uvsdt_m <- bf(y ~ isold, disc ~ 0 + isold)
该模型中有两个brms公式。首先,我们对 y ~ isold已经很熟悉了。在第二个公式中,我们编写disc ~ 0 + isold以防止模型对噪声分布的这个参数进行估计:回忆一下,我们已经将噪声分布的标准差设置为1(通过$\exp(disc * 0) = 1$实现)。在R语言中(以及brms中),建模语法0 + ...意味着从模型中除去截距。通过仅包含isold,我们可以实现如上所述的0/1预测因子。然后,我们可以估算该模型:
fit2 <- brm(uvsdt_m,
            family = cumulative(link="probit"),
            data = d,
            control = list(adapt_delta = .99),
            cores = 4,
            file = here::here("static/data/sdtmodel3-2"))
summary(fit2)
  ##  Family: cumulative
  ##   Links: mu = probit; disc = log
  ## Formula: y ~ isold
  ##          disc ~ 0 + isold
  ##    Data: d (Number of observations: 1188)
  ## Samples: 4 chains, each with iter = 2000; warmup = 1000; thin = 1;
  ##          total post-warmup samples = 4000
  ##
  ## Population-Level Effects:
  ##              Estimate Est.Error l-95% CI u-95% CI Eff.Sample Rhat
  ## Intercept[1]    -0.54      0.05    -0.64    -0.43       3420 1.00
  ## Intercept[2]     0.20      0.05     0.11     0.30       5291 1.00
  ## Intercept[3]     0.71      0.05     0.61     0.82       4472 1.00
  ## Intercept[4]     1.37      0.07     1.25     1.51       2203 1.00
  ## Intercept[5]     2.31      0.11     2.10     2.54       1562 1.00
  ## isold            1.53      0.10     1.35     1.72       1724 1.00
  ## disc_isold      -0.36      0.06    -0.48    -0.24       1501 1.00
  ##
  ## Samples were drawn using sampling(NUTS). For each parameter, Eff.Sample
  ## is a crude measure of effective sample size, and Rhat is the potential
  ## scale reduction factor on split chains (at convergence, Rhat = 1).
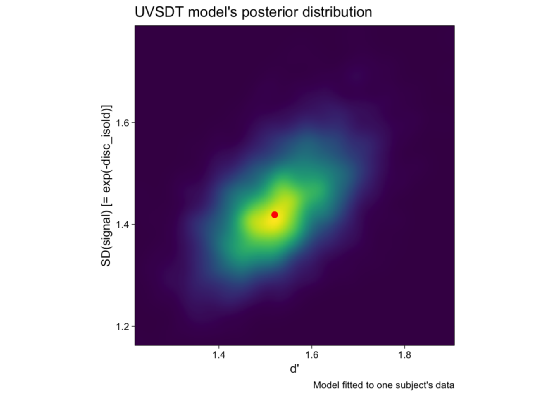
注意,我们需要翻转disc参数的符号以获得。对其求幂为我们提供了信号分布的标准差,并且由于我们是在贝叶斯框架中估算模型,因此我们得到的是该参数的后验分布,绘制在图2的y轴上。
我们还可以将brms的结果与SPSS的结果(Decarl,2003描述的SPSS程序)进行比较:
PLUM y WITH x
  /CRITERIA=CIN(95) DELTA(0) LCONVERGE(0) MXITER(100) MXSTEP(5) PCONVERGE(1.0E-6) SINGULAR(1.0E-8)
  /LINK=PROBIT
  /PRINT=FIT KERNEL PARAMETER SUMMARY
  /SCALE=x .
Parameter Estimates
|-----------------|--------|----------|-----------------------------------|
|                 |Estimate|Std. Error|95% Confidence Interval            |
|                 |        |          |-----------------------|-----------|
|                 |        |          |Lower Bound            |Upper Bound|
|---------|-------|--------|----------|-----------------------|-----------|
|Threshold|[y = 1]|-.533   |.054      |-.638                  |-.428      |
|         |-------|--------|----------|-----------------------|-----------|
|         |[y = 2]|.204    |.050      |.107                   |.301       |
|         |-------|--------|----------|-----------------------|-----------|
|         |[y = 3]|.710    |.053      |.607                   |.813       |
|         |-------|--------|----------|-----------------------|-----------|
|         |[y = 4]|1.366   |.067      |1.235                  |1.498      |
|         |-------|--------|----------|-----------------------|-----------|
|         |[y = 5]|2.294   |.113      |2.072                  |2.516      |
|---------|-------|--------|----------|-----------------------|-----------|
|Location |x      |1.519   |.096      |1.331                  |1.707      |
|---------|-------|--------|----------|-----------------------|-----------|
|Scale    |x      |.348    |.063      |.225                   |.472       |
|-------------------------------------------------------------------------|
Link function: Probit.
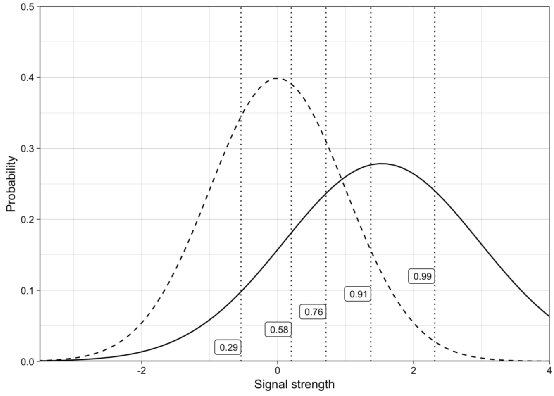
再次,因为我们使用了无信息先验分布(uninformative prior distributions),最大似然估计(SPSS)的结果在数值上与我们贝叶斯的结果相匹配。绘制模型的分布图显示,信号分布比噪声分布具有更大的方差(图3)。
研究者所感兴趣的其他百分比数所对应的量(quantities)可以从参数后验分布中计算得来。从后验中获取样本的一个好处是,如果我们逐行完成这些计算,我们将自动获得这些后验分布(样本)其他百分比数所对应的量。
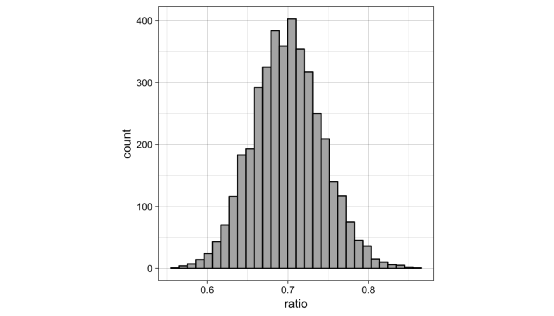
在这里,我们计算这样一个量:噪声与信号标准差之比($\exp(-a)$;注意:我们的模型以disc_isold形式返回-a),这也是z-ROC曲线的斜率。我们将首先获取disc_isold的后验样本,然后计算比率,并汇总后验样本分布中2.5%,50%和97.5%所对应的量。
as.data.frame(fit2, pars = "b_disc_isold") %>%
transmute(ratio = exp(b_disc_isold)) %>%
    pull(ratio) %>%
    quantile(probs = c(.025, .5, .975))
##  2.5%   50% 97.5%
## 0.618 0.699 0.788
这些展示了参数的95%可信区间和中位数。这些可以在出版物中来描述对应的参数。我们还可以将后验分布绘制为直方图:
as.data.frame(fit2, pars = "b_disc_isold") %>%
    transmute(ratio = exp(b_disc_isold)) %>%
    ggplot(aes(ratio)) +
    geom_histogram(col="black", fill="gray70") +
theme(aspect.ratio = 1)
感谢阅读。
参考文献
[1] Bürkner, Paul-Christian. 2017. “Brms: An R Package for Bayesian Multilevel Models Using Stan.” Journal of Statistical Software 80 (1): 1–28. https://doi.org/10.18637/jss.v080.i01.
[2] Decarlo, Lawrence T. 2003. “Using the PLUM Procedure of SPSS to Fit Unequal Variance and Generalized Signal Detection Models.” Behavior Research Methods, Instruments, & Computers 35 (1): 49–56. https://doi.org/10.3758/BF03195496.
[3] DeCarlo, Lawrence T. 2010. “On the Statistical and Theoretical Basis of Signal Detection Theory and Extensions: Unequal Variance, Random Coefficient, and Mixture Models.” Journal of Mathematical Psychology 54 (3): 304–13. https://doi.org/10.1016/j.jmp.2010.01.001.
[4] R Core Team. 2017. R: A Language and Environment for Statistical Computing. Vienna, Austria: R Foundation for Statistical Computing. https://www.R-project.org/.
[5] Stan Development Team. 2016. Stan: A C++ Library for Probability and Sampling, Version 2.15.0. http://mc-stan.org/.