翻译 | 信号检测论的贝叶斯估计 (四)
原标题:Bayesian Estimation of Signal Detection Models, Part 4
原文地址:https://vuorre.netlify.app/post/2017/10/12/bayesian-estimation-of-signal-detection-theory-models-part-4/
原作者:Matti. Vuorre
译者:田宇浩 刘帅呈
校对:胡传鹏 金海洋
分层EVSDT模型
案例数据
为展示如何使用层级EVSDT模型对信号检测论结果进行贝叶斯估计,本文选用了一个包含48名被试的数据。其中每名被试均根据自身对呈现刺激的确信程度报告新刺激(或旧刺激)的评价等级,对刺激的新旧进行6点计分评级:1 =“呈现刺激肯定为新刺激”, …, 6 =“呈现刺激肯定为旧刺激” (Koen etal., 2013)。R语言的MPTinR包中包含该案例数据(Singmann, & Kellen, 2013)。
在该实验中 (Koenet al., 2013),被试完成学习阶段识记后在无干扰条件(全神贯注)或在干扰条件(执行一个额外任务)下完成再认测验阶段。我们这里关注在无干扰条件下被试判断的评级数据。我从该篇文章的附录中摘出了新旧项目判断的计数表如下所示(以确保我们使用了相同的数据)。
| isold | 6 | 5 | 4 | 3 | 2 | 1 |
|---|---|---|---|---|---|---|
| old | 2604 | 634 | 384 | 389 | 422 | 309 |
| new | 379 | 356 | 454 | 871 | 1335 | 1365 |
对于完整的R代码(包括数据的预处理),请参阅这篇博客的源代码(https://github.com/mvuorre/vuorre.netlify.com/blob/master/content/post/2017-10-30-bayesian-estimation-of-signal-detection-theory-models-part-4.Rmd)。为简练起见,本篇博客中省略了一些不太重要的代码。
模型语法
这是我们用于估计单个被试信号检测论模型的brms语法:
uvsdt_m <-bf(y ~ isold, disc ~ 0 + isold)
上述语法是由以下7个参数组成的:在y[1]上的5个截距(在累计概率(cumulative probit)模型中又称为阈限(thresholds));isold 对y的影响;和isold 对辨别参数disc[2]的影响。之所以存在5个截距(阈限)是因为存在6种反应类别。
通过设定所有被试都拥有自己特定的上述参数(数据中的id变量),我们将前面的代码扩展到了层级模型。
  uvsdt_h <-bf(y ~ isold + (isold |s| id),
              disc~ 0 + isold + (0 + isold |s| id))
回想一下以前使用|s|来估计各种变量间相关的博客。与这些阈值相关的只有一个标准差。也就是说,这个模型假设被试所有的阈限相对于均值的变化是相似的。
[1] 截距是自动被包含在模型中,但是截距也能通过添加1到这个公式的右侧来明确地被包含在模型中。[2] 0 + ...移除了这个模型的截距。
先验分布
我设置辨别力指标d’的先验为N(1, 3)(即均值为1,标准差为3的正态分布[3]),因为我知道被试的任务表现通常都很好。可能这个先验分布也受到了我阅读这篇文献的影响!我设置a的先验为N(0, 1):这个参数通常来说是在-1/4左右,但是这里我忽略了这个信息。
我设定被试间标准差的先验分布为 t(7, 0, .33),这反映出我假设被试间应该存在中等程度的相似,但也允许存在更大的偏差(该先验分布表示自由度为7,平均数为0,标准差为0.33的t分布)。
Prior <- c(prior(normal(1, 3), class = "b", coef = "isold"),
          prior(normal(0, 1), class = "b", coef = "isold", dpar = "disc"),
          prior(student_t(7, 0, .33), class = "sd"),
          prior(student_t(7, 0, .33), class = "sd", dpar = "disc"),
          prior(lkj(2), class = "cor"))
估计并总结参数
我们可以像之前一样(参见本系列先前文章)估计这个模型。但请注意,这个模型的估计耗时相当长(注意我已经将默认的2000次迭代次数减少到了500次)。
fit <- brm(uvsdt_h,
           family =cumulative(link="probit"),
           data =d,
           prior =Prior,
           control= list(adapt_delta = .9), inits = 0,
           cores = 4, iter = 500,
           file =here::here("static/data/sdtmodel4-1"))
我们接着展示该模型的参数估计结果。请注意这里有效样本量偏小,并且Rhat说明从后验中提取更多的样本对我们更有利。实际应用的时候,我建议每个链条(chain)要超过500次迭代。
summary(fit)
##  Family: cumulative
##   Links: mu = probit; disc = log
## Formula: y ~ isold + (isold | s | id)
##          disc ~ 0 + isold + (0 + isold | s | id)
##    Data: d (Number of observations: 9502)
## Samples: 4chains, each with iter = 500; warmup = 250; thin = 1;
##          total post-warmup samples = 1000
##
## Group-LevelEffects:
## ~id (Number oflevels: 48)
##                           Estimate Est.Errorl-95% CI u-95% CI Eff.Sample
##sd(Intercept)                 0.35      0.04    0.28     0.43        210
## sd(isold)                     0.79      0.10    0.62     1.01        321
##sd(disc_isold)                0.46      0.05    0.38     0.55        319
##cor(Intercept,isold)         -0.47      0.12   -0.68    -0.22        121
##cor(Intercept,disc_isold)     0.35      0.13    0.08     0.58        273
##cor(isold,disc_isold)        -0.76      0.07   -0.87    -0.61        455
##                           Rhat
##sd(Intercept)             1.03
## sd(isold)                 1.00
##sd(disc_isold)            1.01
##cor(Intercept,isold)      1.03
##cor(Intercept,disc_isold) 1.02
##cor(isold,disc_isold)     1.00
##
## Population-LevelEffects:
##              Estimate Est.Error l-95% CI u-95%CI Eff.Sample Rhat
## Intercept[1]    -0.60     0.05    -0.70    -0.49       200 1.00
## Intercept[2]     0.20     0.05     0.09     0.30       197 1.00
## Intercept[3]     0.69     0.05     0.60     0.80       203 1.00
## Intercept[4]     1.04     0.05     0.94     1.14       212 1.01
## Intercept[5]     1.49     0.05     1.39     1.59       230 1.00
## isold            1.86      0.12    1.63     2.10        119 1.04
## disc_isold      -0.38     0.07    -0.52    -0.25       112 1.05
##
## Samples weredrawn using sampling(NUTS). For each parameter, Eff.Sample
## is a crudemeasure of effective sample size, and Rhat is the potential
## scale reductionfactor on split chains (at convergence, Rhat = 1).
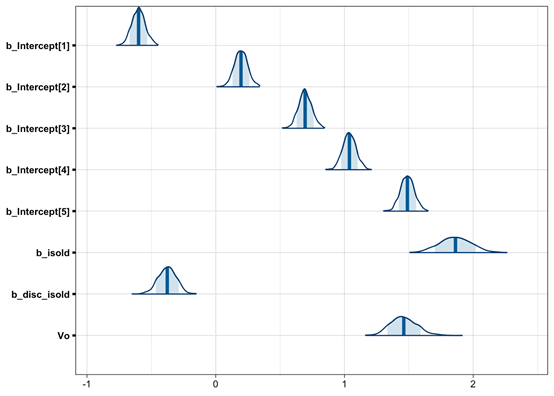
让我们首先看一下“群体水平的效应(Group-Level Effects)”:“人均(average person)”isold的效应就是辨别力指标d’,它非常接近论文中所报告的结果(目测Koen et al. (2013)中的图3得到;这个d’在该论文中未被报告)。由于模型的参数化,disc_isold为−log(σsignal)=−a。这篇论文探讨了Vo=σsignal,因此我们将来自-a中的每个后验样本转换为符合Vo的后验分布样本。
samples <- posterior_samples(fit, "b_") %>%
    mutate(Vo =exp(-b_disc_isold))
我们由此可以对于模型中包括Vo在内的每个样本群体水平的效应绘制密度曲线(Gabry 2017) 。图1表明我们对于Vo的估计与论文报告的结果非常接近(Figure 3 in Koen et al. (2013)).
library(bayesplot)
mcmc_areas(samples, point_est = "mean", prob = .8)
异质性参数
尽管“群体水平估计”(或许更应称为“平均效应”)通常是研究中推断的主要目标,但它们并不是故事的全部,也不一定是所有故事中最有趣的部分。可以确定的是,当允许信号分布的标准差变化时,它通常大于1。但是这个参数在被试间的差异却很少有人关注。图2揭示了a的被试间异质性是相当大的:个体差异的标准差大概在0.5左右。
samples_h <- posterior_samples(fit, c("sd_", "cor_"))
mcmc_areas(samples_h, point_est = "mean", prob = .8)
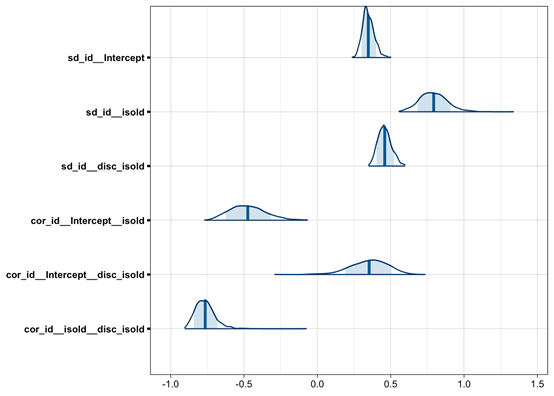
图2还告诉我们,个体差异的辨别力指标d’和与a是相关的(‘cor_id__isold__disc_isold’)。我们可以通过同时绘制信号方差和辨别力指数d’的个体差异来进一步研究这种关系:
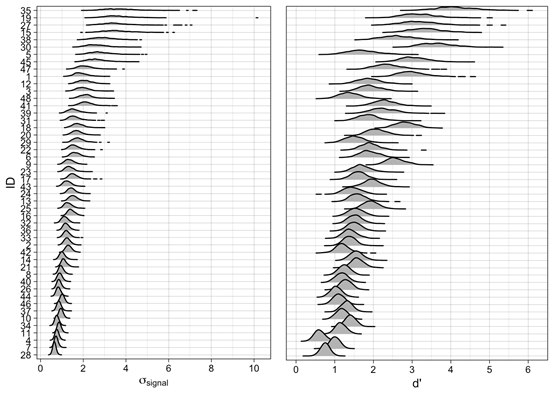
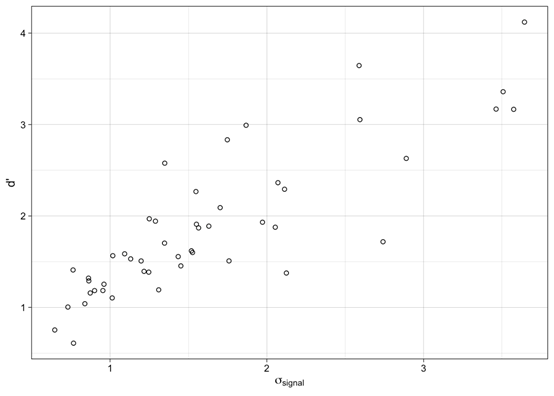
从图3的山脊线图(Wilke 2017)中可以看出,信号标准差(σsignal)越大的被试越倾向于有更大的辨别力指数d’:伴随着信号分布变异性的提高,被试再认的敏感性同样提高。图2的密度图还清楚地表明,我们并不确定哪些被试的(哪一个指标)是更大的,正如后验分布所展示的那样。图4所示的后验均值散点图是可视化这种关系的另一种方法。
总结
使用R的brms包( Bürkner2017)在贝叶斯框架下估计EVSDT和UVSDT模型既简单(相对而言),又可以提供足够的信息。在这篇文章中,我们使用了很少的几行代码估计了一个层级非线性认知模型。以往有关此主题的文献(e.g. Rouder et al. (2007)关注了使用复杂的方法实现更简单的模型(EVSDT)——希望在本文中,我已经展示了,只要对R语言有些了解,这些模型都在可理解的范围内。
值得一提的另外一点是关于层次模型的更普遍的观点:我们知道被试在我们的模型中引入了(随机)变异。忽略这些变异显然是不好的(Estes 1956)。更合适的做法是对这种变异性进行建模,并使用所得的参数来推断个体间的参数异质性(更概括地说,即是认知策略)。尽管最大似然法提供了我在这里所说的被试间异质性参数,但贝叶斯方法可以得出有关这些参数更明确的结论。
参考文献
[1] Bürkner, Paul-Christian. 2017. “Brms: An RPackage for Bayesian Multilevel Models Using Stan.” Journal ofStatistical Software 80 (1): 1–28. https://doi.org/10.18637/jss.v080.i01.
[2] Estes, W.K. 1956. “The Problem of Inferencefrom Curves Based on Group Data.” Psychological Bulletin 53(2): 134–40. https://doi.org/10.1037/h0045156.
[3] Gabry, Jonah. 2017. Bayesplot: Plottingfor Bayesian Models. http://mc-stan.org/.
[4] Koen, Joshua D., Mariam Aly, Wei-Chun Wang, andAndrew P. Yonelinas. 2013. “Examining the Causes of Memory StrengthVariability: Recollection, Attention Failure, or Encoding Variability?” Journalof Experimental Psychology: Learning, Memory, and Cognition 39 (6):1726–41. https://doi.org/10.1037/a0033671.
[5] Macmillan, Neil A., and C. Douglas Creelman.2005. Detection Theory: A User’s Guide. 2nd ed. Mahwah, N.J:Lawrence Erlbaum Associates.
[6] McNicol, Don. 2005. A Primer of SignalDetection Theory. Psychology Press.
[7] R Core Team. 2017. R: A Language andEnvironment for Statistical Computing. Vienna, Austria: R Foundation forStatistical Computing. https://www.R-project.org/.
[8] Rouder, Jeffrey N., Jun Lu, Dongchu Sun, PaulSpeckman, Richard D. Morey, and Moshe Naveh-Benjamin. 2007. “Signal DetectionModels with Random Participant and Item Effects.” Psychometrika 72(4): 621–42. https://doi.org/10.1007/s11336-005-1350-6.
[9] Singmann, Henrik, and David Kellen. 2013.“MPTinR: Analysis of Multinomial Processing Tree Models in R.” BehaviorResearch Methods 45 (2): 560–75. https://doi.org/10.3758/s13428-012-0259-0.
[10] Wilke, Claus O. 2017. Ggridges:Ridgeline Plots in ’Ggplot2’. https://CRAN.R-project.org/package=ggridges.